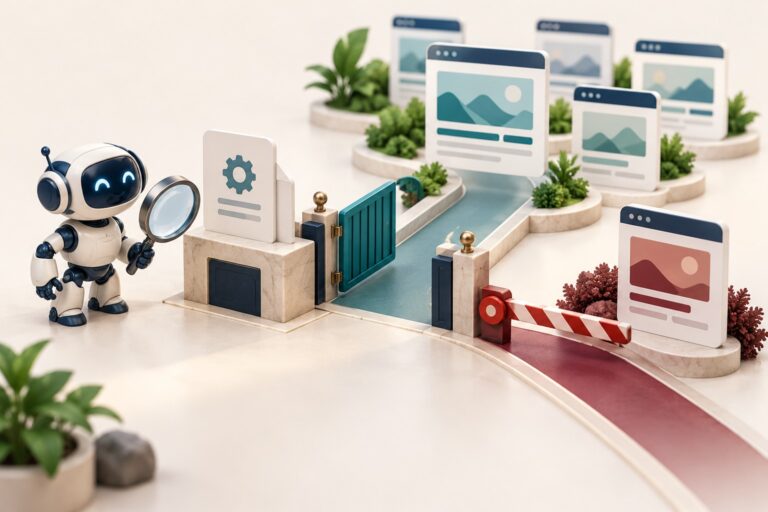
Website sudah memiliki konten lengkap, tetapi halaman penting ternyata tidak bisa dirayapi Google? Salah satu bagian yang perlu diperiksa adalah robots.txt.
File ini sederhana, tetapi perubahan kecil bisa berdampak luas. Satu aturan yang terlalu umum dapat memblokir akses crawler ke halaman produk, artikel, bahkan seluruh website.
Robots.txt adalah file teks untuk mengatur bagian website yang boleh atau tidak boleh dirayapi crawler. Untuk menggunakannya, buat aturan sesuai kebutuhan, publikasikan di direktori utama website, lalu uji terhadap URL penting. Robots.txt bukan alat untuk menjamin halaman hilang dari hasil pencarian.
Berikut panduan membuat dan mengujinya agar tidak salah blokir.
Apa Fungsi Robots.txt untuk SEO?
Robots.txt membantu mengatur aktivitas crawling, yaitu proses crawler mengakses URL dan membaca kontennya.
Penggunaannya dapat dipertimbangkan untuk bagian website yang tidak perlu dirayapi, terutama ketika aktivitas crawling menimbulkan persoalan teknis. Namun, memblokir lebih banyak URL tidak otomatis meningkatkan ranking.
Sebelum menambahkan aturan, tentukan tujuan Anda: ingin membatasi crawling, mencegah pengindeksan, atau melindungi informasi pribadi?
| Tujuan | Pendekatan yang sesuai |
| Membatasi crawling pada URL tertentu | Robots.txt |
| Meminta halaman tidak masuk indeks Google | noindex, dengan akses crawling tetap tersedia |
| Melindungi data pribadi | Autentikasi dan kontrol akses |
| Memberi tahu lokasi sitemap | Deklarasi Sitemap |
Google menegaskan bahwa robots.txt bukan pengaman data. Crawler tertentu dapat mengabaikannya, dan URL halaman yang diblokir masih mungkin muncul di hasil pencarian jika ditemukan melalui tautan lain.
Mengenal Aturan Dasar Robots.txt
Beberapa elemen yang umum digunakan adalah:
| Elemen | Fungsi |
| User-agent | Menentukan crawler yang dituju |
| Disallow | Melarang crawling pada path yang cocok |
| Allow | Mengizinkan crawling pada path yang cocok |
| Sitemap | Menyebutkan URL lengkap sitemap |
| # | Menambahkan komentar |
Untuk Google, path bersifat peka huruf besar dan kecil. Aturan /Produk/ tidak sama dengan /produk/. Google juga tidak mendukung crawl-delay dalam robots.txt.
Cara Membuat Robots.txt untuk Website
1. Tentukan URL yang Memang Perlu Dibatasi
Mulai dari daftar halaman penting dan bagian teknis website.
Halaman beranda, layanan, kategori, produk, serta artikel yang menjadi target SEO umumnya perlu dapat diakses crawler. Jangan memblokirnya tanpa alasan yang jelas.
Untuk URL filter, pencarian internal, atau parameter, periksa dahulu fungsinya. Sebagian URL mungkin memang tidak diperlukan untuk SEO, sementara sebagian lainnya memiliki nilai pencarian.
Hindari menyalin aturan dari website lain hanya karena menggunakan CMS yang sama.
2. Buat File Teks Bernama robots.txt
Gunakan editor teks biasa dan simpan sebagai robots.txt dengan encoding UTF-8. Pastikan nama akhirnya bukan robots.txt.txt.
Contoh sederhana tanpa pembatasan crawling:
User-agent: *
Disallow:
Sitemap: https://example.com/sitemap.xml
Ganti alamat sitemap dengan URL yang benar-benar tersedia di website Anda. Contoh tersebut bukan konfigurasi universal untuk semua situs.
3. Tambahkan Pembatasan Secara Spesifik
Misalnya, Anda memiliki folder percobaan publik yang memang tidak ingin dirayapi:
User-agent: *
Disallow: /uji-layout/
Sitemap: https://example.com/sitemap.xml
Aturan ini mengatur crawling pada folder tersebut. Jika isinya bersifat rahasia, gunakan perlindungan akses, bukan hanya robots.txt.
4. Publikasikan di Direktori Utama Website
File harus tersedia pada alamat seperti:
https://example.com/robots.txt
Bukan:
https://example.com/blog/robots.txt
Metode publikasinya mengikuti sistem website, misalnya melalui hosting, konfigurasi aplikasi, atau fitur CMS. Setelah diunggah, buka alamatnya melalui browser untuk memastikan file dapat diakses publik.
Perlu diperhatikan bahwa aturan berlaku pada host, protokol, dan port tempat file disajikan. Subdomain seperti shop.example.com perlu diperiksa tersendiri.
Contoh Robots.txt untuk WordPress
Untuk instalasi WordPress di direktori utama, pola berikut umum dijumpai:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/wp-sitemap.xml
WordPress memiliki mekanisme bawaan untuk menghasilkan robots.txt, termasuk aturan terkait direktori administrasi dan admin-ajax.php. Hasil akhirnya dapat berubah karena konfigurasi atau plugin.
Sebelum menggunakan contoh tersebut:
- Periksa robots.txt yang sudah aktif.
- Pastikan lokasi instalasi WordPress sesuai.
- Gunakan alamat sitemap yang benar.
- Periksa apakah plugin SEO atau server menghasilkan aturan tambahan.
Jangan langsung memblokir seluruh /wp-content/ karena folder tersebut dapat memuat gambar, CSS, dan JavaScript yang dibutuhkan halaman.
Google menyarankan agar resource penting untuk memahami dan merender halaman tidak diblokir.
Cara Menguji Robots.txt
Pengujian perlu memeriksa dua hal: apakah file dapat dibaca dan apakah aturannya menghasilkan pembatasan yang Anda inginkan.
1. Periksa File yang Benar-Benar Tayang
Buka /robots.txt pada domain aktif menggunakan jendela privat.
Pastikan yang muncul adalah teks aturan, bukan halaman login atau pesan error. Jika menggunakan CDN atau cache, periksa kembali isi yang tersaji setelah perubahan.
File yang tersimpan di komputer belum tentu sama dengan versi yang dilihat crawler.
2. Buat Daftar URL untuk Diuji
Siapkan sampel URL penting sebelum dan sesudah perubahan.
| Sampel URL | Hasil crawling yang diharapkan |
| / | Diizinkan |
| /layanan/seo/ | Diizinkan |
| /blog/panduan-seo/ | Diizinkan |
| /produk/contoh-produk/ | Diizinkan |
| /uji-layout/contoh/ | Diblokir jika memang ditetapkan demikian |
Tambahkan URL gambar, CSS, atau JavaScript penting jika perubahan menyentuh direktori resource.
3. Periksa Laporan Robots.txt di Search Console
Laporan robots.txt Google Search Console menampilkan file yang ditemukan Google, waktu pengambilan, serta masalah pemrosesan.
Gunakan laporan ini untuk membandingkan versi yang terakhir diambil Google dengan file yang sudah Anda publikasikan. Laporan tersebut juga menyediakan permintaan pengambilan ulang untuk perubahan penting.
4. Uji URL Penting melalui URL Inspection
Gunakan fitur URL Inspection, lalu jalankan pengujian URL aktif untuk memeriksa apakah URL dapat diakses Google.
Untuk pengujian lokal sebelum publikasi, Google menyediakan library robots.txt open source. Validator lain dapat membantu, tetapi pastikan interpretasinya sesuai crawler yang dituju.
Hasil “diizinkan untuk crawling” tidak berarti halaman pasti diindeks atau mendapat ranking. Pengindeksan tetap bergantung pada faktor lain.
Kesalahan Robots.txt yang Sering Menyebabkan Salah Blokir
1. Membawa Aturan Blokir Total ke Website Aktif
Contoh berikut memblokir crawling seluruh website bagi crawler yang mengikuti grup tersebut:
User-agent: *
Disallow: /
Aturan ini perlu mendapat perhatian khusus saat website dipindahkan dari lingkungan pengembangan ke produksi.
Bandingkan dengan:
User-agent: *
Disallow:
Nilai Disallow yang kosong tidak menetapkan larangan crawling. Perbedaan satu garis miring dapat mengubah cakupan aturan secara drastis.
2. Menggunakan Pola Parameter Terlalu Luas
Contoh berisiko:
User-agent: *
Disallow: /*?
Pola ini dapat mencakup seluruh URL yang mengandung tanda tanya, termasuk URL yang sebenarnya masih dibutuhkan.
Sebelum memblokir parameter, inventarisasi fungsi dan contoh URL-nya. Gunakan pola yang lebih spesifik jika pembatasan memang diperlukan.
3. Menganggap Aturan Terakhir Selalu Menang
Google menggunakan aturan yang paling spesifik berdasarkan panjang path. Jika aturan yang bertentangan memiliki tingkat kecocokan sama, aturan yang lebih longgar digunakan.
Contohnya:
User-agent: *
Disallow: /panduan/
Allow: /panduan/seo/
URL /panduan/seo/dasar/ mendapat izin dari aturan yang lebih spesifik. Tetap uji URL nyata sebelum menerapkan perubahan.
4. Memblokir Halaman yang Memiliki Noindex
Jika Google tidak dapat merayapi halaman, Google tidak dapat membaca instruksi noindex di halaman tersebut.
Apabila tujuannya mengeluarkan halaman dari indeks, pastikan Google dapat mengaksesnya untuk membaca instruksi tersebut. Google juga tidak mendukung penulisan aturan noindex di dalam robots.txt.
5. Menganggap Sitemap Membatalkan Disallow
Mencantumkan URL dalam sitemap tidak membatalkan aturan pemblokiran.
Jika halaman penting terblokir, perbaiki aturan yang cocok dengan URL tersebut. Jangan hanya mengirim ulang sitemap dan berharap pembatasannya terlewati.
Apa yang Harus Dilakukan Jika Halaman Penting Salah Terblokir?
Lakukan langkah berikut:
- Simpan salinan robots.txt yang sedang aktif.
- Identifikasi aturan yang memblokir URL.
- Perbaiki pembatasan tanpa menghapus aturan lain secara sembarangan.
- Publikasikan perubahan dan periksa versi tayangnya.
- Uji kembali URL penting.
- Minta pengambilan ulang robots.txt melalui Search Console jika perubahan bersifat kritis.
- Pantau laporan pengindeksan dan perkembangan crawling.
Google menggunakan cache robots.txt, sehingga perubahan belum tentu langsung terbaca. Dokumentasi Google menjelaskan bahwa permintaan pengambilan ulang dapat digunakan untuk mempercepat pembaruan salinan yang disimpan.
Pulihnya akses crawling juga tidak menjamin trafik langsung kembali. Periksa faktor teknis lain jika masalah berlanjut.
FAQ Robots.txt untuk SEO
Apakah semua website wajib memiliki robots.txt?
Tidak. Tidak adanya robots.txt bukan otomatis masalah SEO. Namun, jika membutuhkan kontrol crawling, buat dan uji aturannya sesuai kebutuhan.
Apakah robots.txt bisa menghapus halaman dari Google?
Tidak dapat diandalkan untuk tujuan tersebut. Gunakan metode pengendalian indeks yang sesuai, seperti noindex, dengan memperhatikan akses crawling.
Apakah robots.txt meningkatkan ranking?
Robots.txt membantu pengaturan crawling. Penggunaannya tidak memberikan jaminan peningkatan ranking.
Apakah robots.txt perlu dikirim ulang setiap selesai diedit?
Biasanya Google akan mengambilnya kembali secara otomatis. Permintaan pengambilan ulang dapat dipertimbangkan untuk perbaikan kritis.
Apakah robots.txt dapat melindungi halaman admin?
Robots.txt tidak menggantikan login, autentikasi, dan pengamanan server. Terapkan kontrol akses untuk bagian yang bersifat pribadi.
Pastikan Halaman Bisnis Anda Bisa Diakses Google
Konten yang sudah dikerjakan dengan serius perlu didukung konfigurasi teknis yang tepat. Mulailah dengan memastikan halaman layanan, produk, dan artikel penting tidak terblokir tanpa sengaja.
DIFITECH | Digital Marketing Agency menyediakan layanan SEO dan pengembangan website untuk mendukung kebutuhan pemasaran digital bisnis.
Sudah rutin membuat konten, tetapi halaman penting masih sulit ditemukan di Google? Yuk, konsultasikan kondisi website Anda dengan DIFITECH. Bahas kendala crawling, pengindeksan, dan kebutuhan optimasinya agar langkah perbaikan lebih terarah.